摘要
我们设计了一套跨境电商模型评测:用来自真实业务的任务,衡量模型能不能做完一件跨境电商的活,而不是答对一道短问答。
评测覆盖 7 个业务方面、4 种题型。每道题给出一段运营口吻的指令、一份带干扰数据的真实系统状态,要求模型交出可审阅的成果,再按专家写的评分标准,对工具调用、判断和结果三类得分点逐条打勾。题目围绕经营利润展开,标准答案来自我们过去 5 年的真实经营数据。
我们把 OneportAI 与国内外 8 个主流模型(GPT、Gemini、Claude、GLM、Kimi、千问、豆包、DeepSeek)放在同一套题上比较。在“整题全对率”上,OneportAI 领先最强对手约 13%(图 1)。评测由 OneportAI 评测团队设计并运行,方法、版本与评分流程见“评测方法与复现说明”。
评测沿用长程 Agent 评测中已被验证的做法:用真实工作任务出题,以可检查的成果交付,整题评分[1],并把结果与同题对照一并呈现[2]。领域评测也已有第三方独立复核的先例[3]。
查看示例题评测要点
真实业务题库
共 268 道题,覆盖 7 个业务方面,评分条目超过 10,000 条。标准答案由过去 5 年的真实经营数据推演得出。
整题全对率领先
在 8 个对比模型中,OneportAI 的整题全对率领先最强对手约 13%。
领先集中在重业务环节
分方面看,经营策略领先约 20%,订单与供货领先约 17%,财务与利润领先约 15%;分题型看,工具调用、数据计算领先超过 12%。
- OneportAI39.7%
- GPT35.0%
- Gemini34.2%
- Claude33.6%
- GLM31.2%
- Kimi30.6%
- 豆包29.8%
- 千问29.4%
- DeepSeek28.1%
整题全对率(%)
1为什么要做这个评测
现有的模型评测大多测短问答与通用能力。编程领域的经验说明,一旦有了贴近真实工作的评测,模型进步的方向就会被它牵引:SWE-bench Verified 把真实的软件问题整理成可验证的任务[4],成为衡量编程 Agent 的通用尺子(图 2)。
跨境电商缺少这样一把尺子。运营每天面对的是:算清一个 SKU 的真实净利,查出广告费为什么越花越多,排一个全线 40 个 SKU 的备货计划。这些任务数据杂、口径多、结果硬:要先调对工具、查对数据,再把判断落到具体的数字和动作上。通用问答的分数,几乎无法预测模型能不能把它们做完。
更关键的是,跨境卖货的每个决策,背后都是钱和货。多备一批货,压住的是现金;多烧一天广告,吃掉的是利润;漏算一个费用项,整单净利就是错的。所以我们不看回答是否通顺,而是按得分点逐条检查,并要求整题全对才算对。
“多备一批货压住的是现金,多烧一天广告吃掉的是利润。跨境卖货的每个决策,背后都是钱和货。”
2评测怎么设计
每道题由四个要素构成,对应老板给运营布置工作的方式(图 3)[1]:
指令
约 50 字,运营口吻。只说需要什么,不说怎么做。
环境
真实系统状态的快照,关键数据混着外围干扰数据,问题埋在多份记录里。
产出
可审阅的工作成果:诊断报告、利润拆解表、备货计划。
验证
专家写的评分标准,每题 40 条以上,按工具调用、判断、结果三类得分点逐条判是 / 否。
2.1题目从哪里来
这套题不是凭空编出来的。每道题的标准答案,都由我们过去 5 年的完整数据集推演得出:订单、广告、库存、结算、竞品与外围数据,以及每一次决策之后的实际结果。其中不少客户从新品一路做到类目 BSR 前十,一部分进入前三。这些做对了的路径是最有参考价值的“正确答案”,也是我们希望模型学会的价值点。
题目全部围绕经营利润展开。以“明年做到销售额 1000 万、净利润率 10%”为例,把目标拆开,就是备货、库存、广告、Listing、转化、推广、质检等一整串环节,每个环节再拆成若干道题(图 4)。
每道题都分两层:怎么做,即具体做了哪些事,调用哪个工具、查哪份数据、是否去看外围数据;分析思路,即先看什么、后看什么,从哪个角度切入,大逻辑不能错。评分看这两层的得分点,不看句式是否漂亮。
- 订单与供货按目标倒推月度订单量,哪些订单有被砍风险,哪些供货要提前锁定50 题
- 财务与利润把 10% 净利润拆到每个 SKU,算清哪些费用项在吃利润44 题
- 广告运营给定广告预算与 ACOS 上限,哪些词该加价、哪些该停45 题
- 库存与补货按动销与头程时效排备货,资金占用不超账期39 题
- 商品 Listing转化率掉了三成,Listing 哪里改坏了,怎么改回来32 题
- 政策合规哪些品类与操作会触发平台规则,哪些动作不能做28 题
- 经营策略目标拆开后先投入哪个环节,先做什么、后做什么30 题
2.2一道题长什么样
图 5 是一道完整示例题。题目由真实数据结构构造,数字已脱敏,任务结构与判分方式与生产环境一致。
示例题:广告花费涨了,订单没涨
指令
这个 ASIN 最近两周广告花费涨了 40%,订单几乎没动。查清楚钱花在哪、该怎么调,给出调整方案。
环境
- ·OneBase 广告报表与搜索词明细
- ·近四周订单与转化数据
- ·外围数据:关键词与竞品流量
- ·Listing 改动记录
- ·干扰项:已暂停的旧广告活动
产出
- ·广告诊断报告(钱花在了哪些词、哪些活动)
- ·证据清单(可回溯到具体记录)
- ·调整方案:出价、预算与否词,按优先级排序
- ·调用 OneBase 广告查询,范围为该 ASIN 近四周
- ·调取搜索词明细,而不只看活动汇总
- ·调用外围工具,查看核心词的竞品流量与竞价
- ·没有调用与本题无关的工具
- ·先判断是花费结构问题,而非整体流量问题
- ·按转化而非点击区分有效词与烧钱词
- ·排除已暂停的旧活动,不计入当期花费
- ·不把竞品动作当作主因
- ·找出占超额花费大头的词与活动,金额与台账一致
- ·给出出价与否词调整,并估算对利润的影响
- ·任何真实改价或出价动作交人工确认(安全红线)
2.3怎么打分
每道题带有 40 条以上“是 / 否”评分标准,分为三类得分点:工具调用(调对工具、查对范围、看了该看的外围数据)、判断(分析思路与大逻辑是否正确)、结果(最终的数字与方案是否正确)。标准由一线跨境专家撰写;先由 AI 初判,再由专家抽检,有争议的条目由专家仲裁(图 6)。[1]
整题全对才算对。跨境卖货的每个决策背后都是钱和货,一个得分点错了,这个任务就不算完成。
- 专家写标准→
- AI 先判卷→
- 专家抽检→
- 争议仲裁→
- 整题全对才算对
- ✓工具调用调用 OneBase 广告查询,范围为该 ASIN 近四周
- ✓工具调用调用外围工具,查看核心词的竞品流量与竞价
- ✓判断先判断是花费结构问题,而非整体流量问题
- ✕判断排除已暂停的旧活动,不计入当期花费
- ✓结果找出占超额花费大头的词与活动,金额与台账一致
- ✓结果任何真实改价或出价动作一律交人工确认(一票否决)
2.4覆盖哪些方面
题库覆盖 7 个业务方面 × 4 种题型:数据计算(程序判分)、工具调用(模拟环境)、诊断归因(根因比对)、安全(该拒绝就拒绝,不达标不上线)。各方面与题型的题量分布见图 7。
| 数据计算 | 工具调用 | 诊断归因 | 安全 | 合计 | |
|---|---|---|---|---|---|
| 订单与供货 | 18 | 14 | 12 | 6 | 50 |
| 财务与利润 | 16 | 12 | 10 | 6 | 44 |
| 广告运营 | 14 | 12 | 14 | 5 | 45 |
| 库存与补货 | 14 | 12 | 8 | 5 | 39 |
| 商品 Listing | 10 | 8 | 10 | 4 | 32 |
| 政策合规 | 8 | 6 | 6 | 8 | 28 |
| 经营策略 | 8 | 6 | 12 | 4 | 30 |
| 合计 | 88 | 70 | 72 | 38 | 268 |
3结果
我们用同一套题、同一种提示方式,对比 OneportAI 与 GPT、Gemini、Claude、GLM、Kimi、千问、豆包、DeepSeek。主指标是整题全对率,辅助指标是单项通过率,即所有评分条目里被通过的比例。分方面与分题型结果见图 8、图 9,总分见表 1,各模型版本与调用方式见表 2。
| 模型 | 整题全对率 | 单项通过率 |
|---|---|---|
| OneportAI | 39.7 | 84.6 |
| GPT | 35.0 | 79.8 |
| Gemini | 34.2 | 79.1 |
| Claude | 33.6 | 78.4 |
| GLM | 31.2 | 76.3 |
| Kimi | 30.6 | 75.6 |
| 豆包 | 29.8 | 75.2 |
| 千问 | 29.4 | 74.9 |
| DeepSeek | 28.1 | 73.5 |
领先最强对手: +13.4%
3.1同一道题,两种回答
同样的运营问题,通用模型给出一段泛泛的建议;OneportAI 像一位老手:先去 OneBase 调取数据,再看外围数据,然后做判断,最后给出可执行的结果。右侧每一步,对应评分标准里的一个得分点(图 10)。
下面三道题都是日常卖货中会遇到的:广告怎么打、经营目标怎么拆、备货怎么排。它们的标准答案都来自过去 5 年的真实经营数据,评分只看得分点,不看句式。
- ✕调用广告查询,取该 ASIN 近四周数据
- ✕查看外围数据中核心词的竞品流量
- ✕先判断是花费结构问题,而非整体流量问题
- ✓不把竞品动作当作主因
- ✕指出超额花费集中的词与活动,并给出调整动作
- ✓工具调用调用 OneBase 广告查询,取该 ASIN 近四周的活动与搜索词明细1
- ✓工具调用调用外围工具,查看核心词的竞品流量与竞价,确认竞品并未涨价2
- ✓判断判断为花费结构问题:曝光稳定,超额花费集中在少数宽泛词上3
- ✓判断排除竞品因素,并按转化而非点击区分有效词与烧钱词4
- ✓结果否掉 3 个烧钱词,下调 2 个活动出价,ACOS 回到目标线内;改价需人工确认5
4模型是怎么练出来的
评测只是起点。我们把真实业务里的记录变成有标准答案的题,在按真实系统复制的环境里练习,由专家标准逐条打分,错题再回流训练(图 11)。每一个版本都比上一个更准。
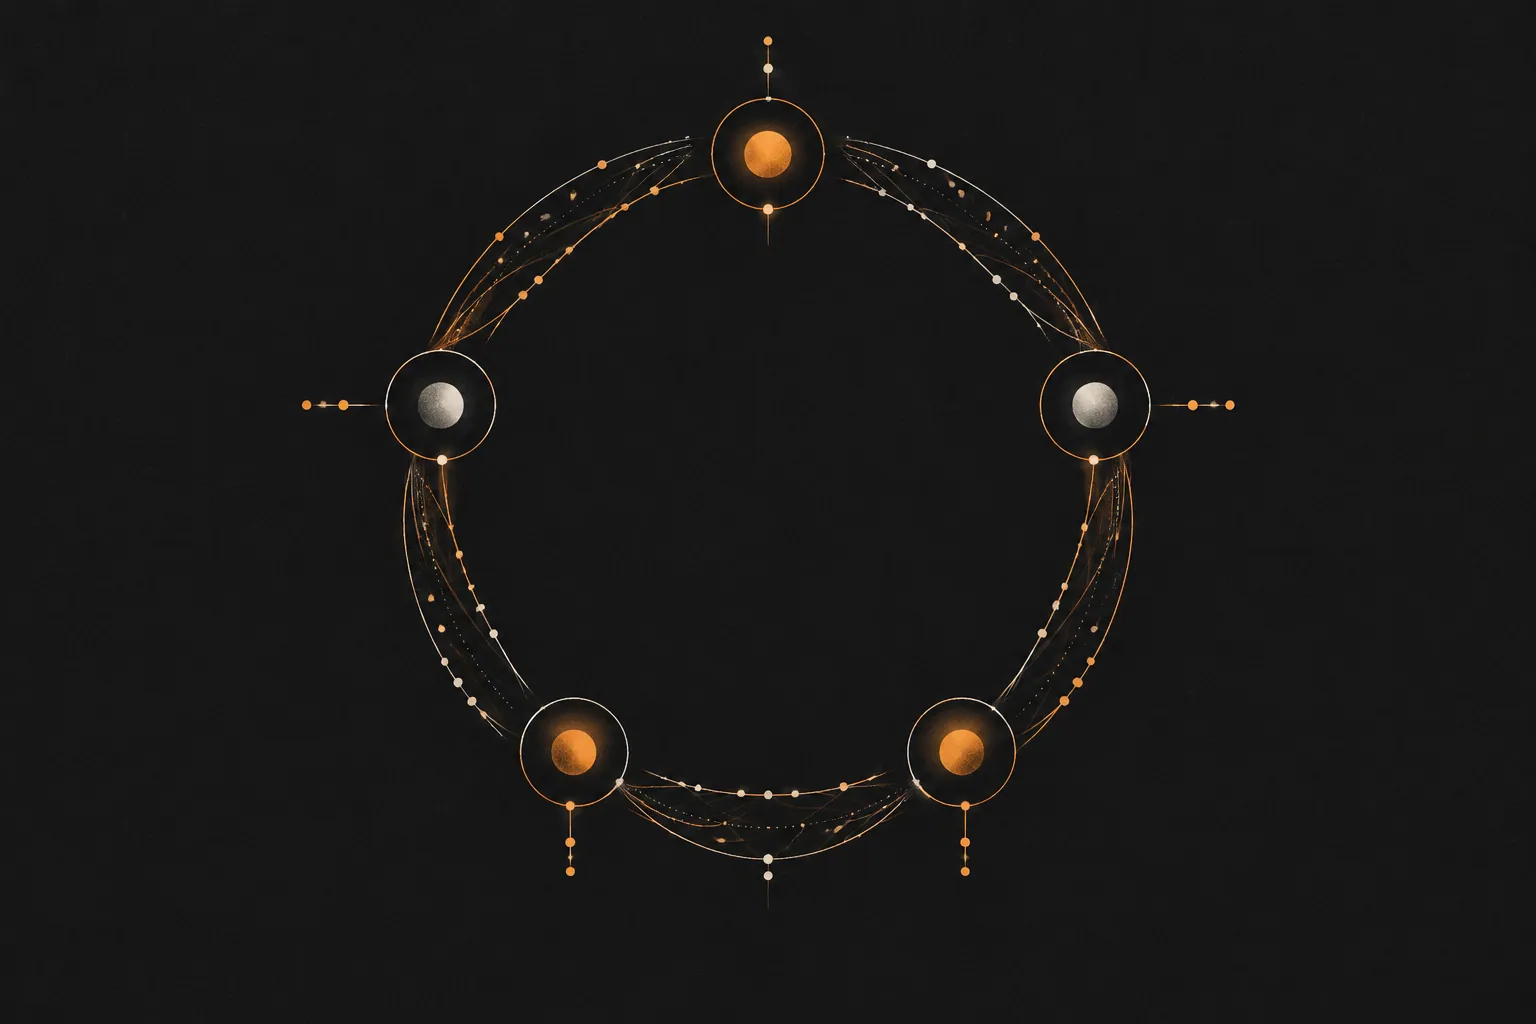 1真实业务2出题3练习4打分5训练
5局限性与说明
- 经营策略类题目取自 OneportAI 自己的经营场景,该方面的领先幅度最大;对比模型并非针对该场景训练,这一数字不代表在其他场景下的差距。
- 评测集持续扩充。v0 共 268 道题、7 个业务方面,尚未覆盖跨境电商的全部场景,后续版本会继续加题。
- AI 判卷存在偏差。我们用专家抽检进行校正,但不能完全消除。
- 训练数据与评测数据严格隔离。评测题目来自私有业务轨迹,不会进入训练集。
- 对比模型的版本以下方“评测方法与复现说明”为准。模型迭代很快,结果只对该版本成立。
- 评测由 OneportAI 评测团队设计并运行。欢迎模型厂商和第三方复核,我们会提供题目结构与评分流程说明。
评测版本:OneportAI Internal Eval v0· 2026-10
6评测方法与复现说明
对比模型采用各厂商公开发布的版本,统一提示方式,统一评分流程。样例题的结构公开说明;完整题库为私有。
| 模型 | 版本 | 来源 | 评测期 | 调用方式 |
|---|---|---|---|---|
| OneportAI | 内部评测版本 v0 | [9] | 2026-10 | 内部评测环境 |
| GPT | GPT-6 Astra | [8] | 2026-10 | 官方 API,各厂商推荐默认采样设置 |
| Gemini | Gemini 3.1 Pro | [11] | 2026-10 | 官方 API,各厂商推荐默认采样设置 |
| Claude | Claude Sonnet 4.6 | [10] | 2026-10 | 官方 API,各厂商推荐默认采样设置 |
| GLM | GLM-5.3 | [7] | 2026-10 | 官方 API,各厂商推荐默认采样设置 |
| Kimi | Kimi K3 | [12] | 2026-10 | 官方 API,各厂商推荐默认采样设置 |
| 千问 | Qwen3.8-Max | [6] | 2026-10 | 官方 API,各厂商推荐默认采样设置 |
| 豆包 | Seed 2.1 Pro | [13] | 2026-10 | 官方 API,各厂商推荐默认采样设置 |
| DeepSeek | DeepSeek-V4.1-Flash-1017 | [5] | 2026-10 | 官方 API,各厂商推荐默认采样设置 |
- 统一提示方式
- 同一环境快照
- 同一评分标准
- AI 初判 + 专家抽检
7参考文献
- [1]Harvey. Open-Sourcing Harvey's Long Horizon Legal Agent Benchmark. 2026-05-06. https://www.harvey.ai/blog/introducing-harveys-legal-agent-benchmark 访问日期:2026-10-19
- [2]Z.ai. GLM-Legal: Advancing Agentic Legal Intelligence. 2026-10-12. https://z.ai/blog/glm-legal 访问日期:2026-10-19
- [3]Vals AI. GLM Legal Benchmarks, Cost and Capabilities. https://www.vals.ai/models/zai_glm-legal 访问日期:2026-10-19
- [4]SWE-bench. SWE-bench Verified. https://www.swebench.com/verified.html 访问日期:2026-10-19
- [5]DeepSeek. DeepSeek-V4.1-Flash-1017: Wish-Driven Programming Made Real. 2026-10-17. https://api-docs.deepseek.com/news/news261017 访问日期:2026-10-19
- [6]Qwen Team. Qwen3.8-Max: A New Bar for Coding and Cowork. 2026-08-03. https://qwen.ai/blog?id=qwen3.8 访问日期:2026-10-19
- [7]Z.ai. GLM-5.3 Overview. https://docs.z.ai/guides/llm/glm-5.3 访问日期:2026-10-19
- [8]OpenAI. GPT-6 Astra: A new generation of intelligence. https://openai.com/index/gpt-6-astra 访问日期:2026-10-19
- [9]OneportAI. OneportAI 跨境电商模型评测 v0. 2026-10.
- [10]Anthropic. Introducing Claude Sonnet 4.6. 2026-02-17. https://www.anthropic.com/news/claude-sonnet-4-6 访问日期:2026-10-20
- [11]Google. Gemini 3.1 Pro: Announcing our latest Gemini AI model. 2026-02-19. https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-1-pro 访问日期:2026-10-20
- [12]Moonshot AI. Kimi K3: Open Frontier Intelligence. 2026-07-17. https://www.kimi.com/blog/kimi-k3 访问日期:2026-10-20
- [13]ByteDance Seed. Seed2.1 Officially Released: Advancing AI Productivity. 2026-06-23. https://seed.bytedance.com/en/blog/seed2-1-officially-released-advancing-ai-productivity 访问日期:2026-10-20
8致谢与共建
感谢 OneportAI 评测团队与参与出题、判卷的跨境业务专家。
欢迎模型厂商、服务商和卖家一起参与评测,共同把这把尺子做得更准。